Bonjour
Je poste ici sans trop savoir ou placer ce sujet
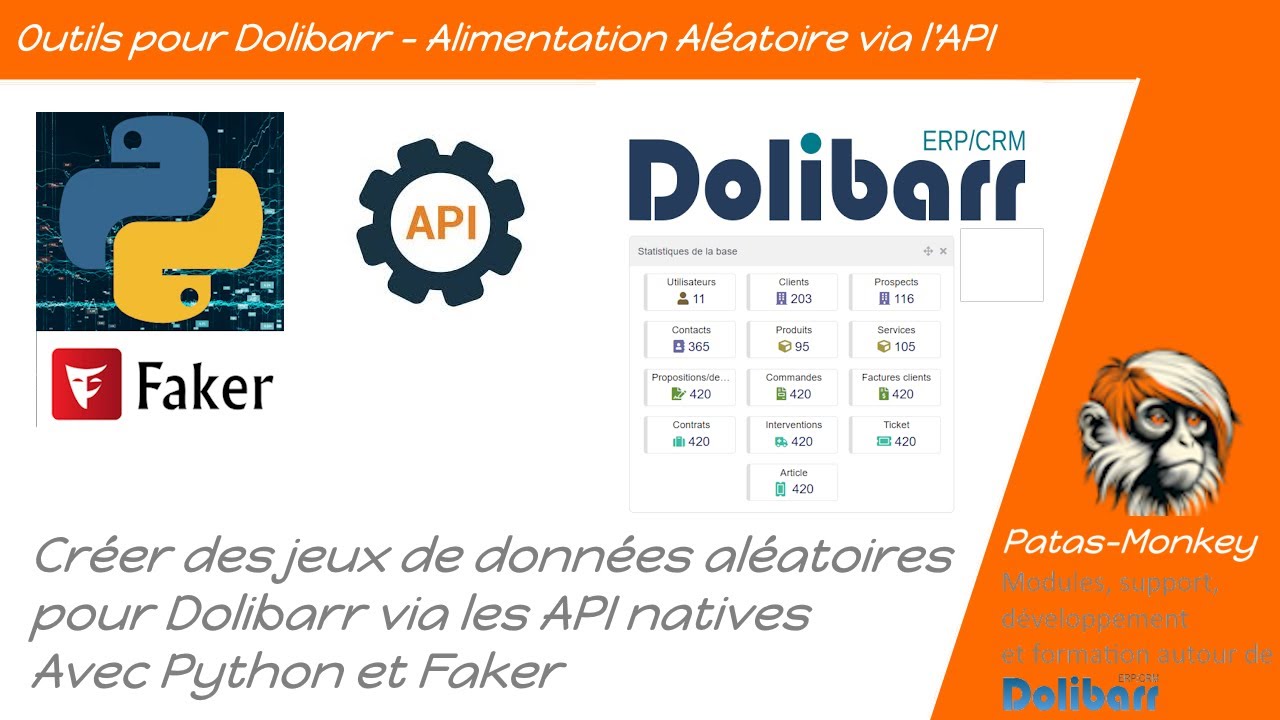
J’ai développé et posté sur mon github un programme python permettant de générer aléatoirement de la données dans dolibarr.
Le programme effectue son alimentation avec les api native (pas besoin d’avoir un accès à la base de données et c’est fonctionnellement plus « propre »)
Le but étant d’avoir de la data pour faire des tests de volumétrie dans le cadre d’un projet perso
Je rajouterai (ou si d’autres on envie de s’en occuper) des éléments (inter, ticket, …) au fil de mes besoins.
dans les fichiers .txt tu précises l’url de l’api et le token
c’est pour l’instant dans le programme que l’on définie le nombre d’élément que l’on souhaite créer :
Oui, ensuite on ne teste pas l’interface de création, mais pour vérifier des performances de volumétries et le choix d’index c’est pas mal aussi. Idem pour benchmarker des serveurs : on lance le programme avec le meme nombres d’éléments à créer et on regarde le résultat en terme de temps de traitement (je sens qu’il y a des hébergeurs qui vont avoir des sueurs froides…)
et oui on peux même choisir des spécificités locales pour les nom des personnes.
Pour le moment il y a pas mal de paramètres qui sont directement dans le code du programme, comme le nombre d’éléments, l’intervale de date, le nombre de ligne (min, max), … mais cela évoluera dans le temps.
oui tout à fait, c’est bien un programme pour « remplir » dolibarr et ne pas avoir une instance toute vide pour tester etc.
Le fait de pouvoir alimenter un nombre précis de produits etc c’est top.
hello
un petit up du programme d’import, avec cette fois :
l’ajout d’un seul fichier de paramétrage au format yaml
mise à jour de l’alimentation des fiches d’interventions pour avoir des dates antérieurs (pour cela il faudra attendre la V22 ou passer un ch’tit patch)
les commandes ont aussi plusieurs statut différents, il me reste à gérer les status des factures, mais il y en a un paquet, sans parler des règlements.
je précise le fonctionnement d’affectation des status:
avant l’année en cours, les éléments sont terminés
durant l’année en cours, soit à l’état brouillon soit validé.
Je verrais plus tard comment gérer cela de manière plus cohérente, mais cela me permet de voir déjà pas mal de trucs en terme de stats notament.
Je vais attaquer la partie mouvement de stock cette semaine, sans doute aussi les contrats, tickets et la base de connaissance. La semaine prochaine ce sera la partie hrm, création d’utilisateur, congé et note de frais.
Je me garde les expéditions et les projets/tache pour la fin du mois.
Ensuite on pourra lancer des alimentations en masse histoire de voir comment dolibarr réagit a 1.000, 10.000 100.000 enregistrements (voir le millions qui sait).
J’aimerai aussi faire un benchmark avec postgres, histoire de voir ce que cela donne en terme de perf, cela me permettra d’étoffer mon cours de SQL avec des volumétries et des requêtes amusantes.
C’est le petit up/mise à jour du soir
j’ai ajouté la mise à jour du stock initial des produits
les utilisateurs, les contrats, les tickets et la base de connaissance c’est bon (mais il y a pas mal de PR à réaliser).
J’ai prévu de réaliser encore l’ajout de contact aux éléments, la gestion de catégorie et les expéditions (le meilleur pour la fin) et je me consacrerai aux tests de charges.
Je me rend compte qu’il manque pas mal de truc pour visualiser les volumétries dans dolibarr . Par exemple pas de stat sur les tiers, contrats la base de connaissance, absence de page d’index sur la base de connaissance…
Je vais tenter de faire le tour pour les rajouter avant le freeze.
La présence de métrique sur les volumes présents peut avoir du sens quand on fait une démo de dolibarr, mon idée étant de pouvoir générer rapidement une base avec 3 années de data, parcourir l’ensemble des éléments et vérifier l’absence d’erreur…
Dans la meme veine, monter un scrappîng de parcours de dolibarr afin de valider la présence de message d’erreur et meme chronométrer le parcours afin de détecter si d’une version à l’autre, selon la base de données ou la présence de memcached on a des améliorations.
Hello, juste annoncer que j’ai terminé cette partie, pour celle et ceux qui souhaitent l’utiliser, la liste des pr nécessaires à sont fonctionnement sont noté dans le readme. Je m’avance un peu mais ils devraient être présent dans la prochaine V22
Il me reste encore un truc à gérer pour mon projet, c’est le payement des factures, avec des écritures sur les comptes bancaires, ce sera sans doute réglé demain.
Pour avoir un outili exaustif, il faudrait aussi que je traite la partie fournisseur, les projets et les RH, ce sera sans doute fait sur le second semestre, pour la V2 de mon projet, mais rien d’urgent, on a déjà de quoi bien jouer
Pour ce qui est des catégories et des contacts interne/externe, tout n’est pas encore présent dans les API.
Pour les Catégories, sont présent tiers, contact et produit
Pour les contact externe/interne, c’est devis, commande et facture.
Je devrais sortir une petite vidéo présentant l’utilisation du module
A titre d’information,
Alimenter 2 ans 1/2 de données (environ 400 éléments) prend 30 mins sur un macbook M1 avec un dolibarr dockerisé
Je n’ai pas détecté de ralentissement à l’usage
Hello
et une vidéo de présentation du programme ici :
Avec les derniers éléments ajoutés, notament les expéditions et le règlement des factures, sur un core I5 je suis à près d’une heure pour alimenter Dolibarr avec 2 ans 1/2 de données.
A titre d’information, en activant le mode production de l’api, on gagne 10mins sur le temps de traitement (50min au lieu d’une heure), mais je ne suis pas certaine si la présence d’obs (pour enregistrer la vidéo) n’a pas aussi un impact sur la durée de traitement.
Comme j’ai à présent les données que je souhaitais pour mon propre besoin, je vais faire une pause sur cet outil.
J’ai posté un PR permettant de d’activer/désactiver les modules, je suis encore en train de le tester, on verra si il est accepté comment implémenter une chaine « complète ».
Je vais aussi plus travailler sur les API de mes propres modules.
Un nouveau module permettant de faire pas mal de trucs autour des API est en cours de finalisation, il sera présenté lors du DevCamp de Valence (attendez-vous à du TRES TRES LOURDS)